搭建知识库:五步走通 RAG 问答
知识库让机器人根据你给的资料回答问题:上传产品手册、社群指南、课程笔记,提问时 Agent 自动检索相关片段再作答。这是检索增强生成(RAG)——上传资料不会训练模型,答案也不保证全对。4.5.0 起原生内置,不用装插件。
第一步:配嵌入模型
前置条件,没配的先去嵌入与重排序。「模型提供商 → 嵌入 → 新增」,OpenAI 兼容服务、Gemini、Ollama、阿里云百炼、NVIDIA 都可选。重排序模型可选,不配也能建库。
第二步:创建知识库
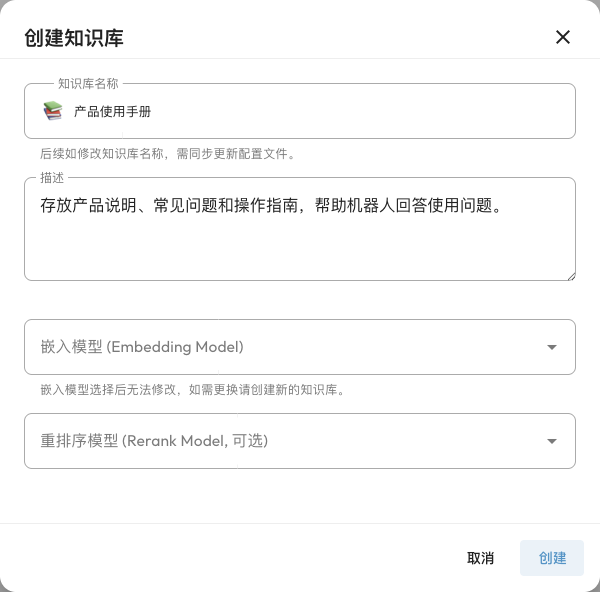
- 「知识库」→「创建知识库」
- 填好识别度高的名称(如「社群新人指南」)和描述
- 嵌入模型选刚配的提供商;重排序可选
- 创建
建库后嵌入模型不可换——换模型等于旧索引全部作废,只能建新库重传资料。也别直接改被引用的提供商的模型或维度,同样会让索引不兼容。
第三步:上传资料
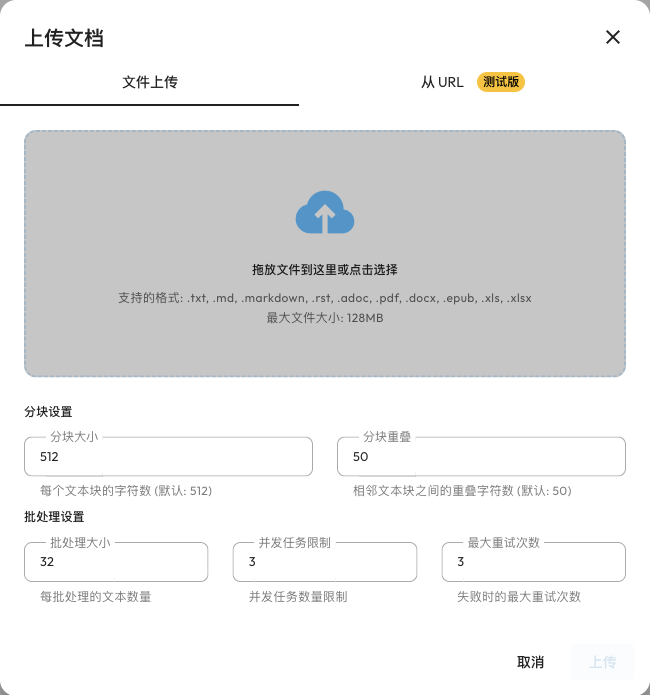
- 进入知识库的「文档管理」→「上传文档」
- 拖入文件,可多选;支持 txt、md、pdf、docx、epub、xls/xlsx 等格式,单文件上限 128MB
- 分块参数首次用默认值即可:分块大小 512、重叠 50、批处理 32、并发 3、重试 3
- 等解析分块完成,文档列表出现分块数即成功
资料相关提醒:扫描版 PDF 不会自动 OCR,先转文字版;大资料按主题拆文件更好维护;改默认分块设置只影响以后的上传,已传的不会重切。
网页导入走「从 URL」标签,用 Tavily 提取网页内容(测试版功能,读默认配置文件里的 Tavily Key),导入的是当时快照,网页后续更新不会同步。
第四步:先测检索
上传成功不等于聊天里能用,更不等于能答对。 在知识库详情的「知识库检索」标签里:
- 输入一个文档里确实有答案的问题
- 点检索,看返回片段和所属文档
- 片段里真有答案,再往下走;没有就回头修文档和分块,别急着怪模型
第五步:接入聊天
- 「配置文件」→ 选机器人用的那份
- 「AI → 能力 → 知识库」的知识库列表里勾选一个或多个
- 保存配置,去会话里提问验证
检索模式两种:普通检索(默认,每次消息都先检索)和 Agentic 检索(把检索做成工具,模型自己决定何时查,需要模型支持工具调用)。检索数量默认融合 20 条、最终给模型 5 条,先不动,按实测调。给特定群单独挂库用自定义规则,会话级选择优先于配置文件。
维护与排障
- 更新资料 = 删旧文档传新版,避免新旧规则并存打架;删除不可恢复,保留原始备份
- 检索不到答案:查分块内容、换更明确的问题、调分块与检索数量、加重排序
- 检索有结果但机器人不用:确认配置文件勾了库、没被会话规则覆盖,人格里补「优先依据检索资料回答」
- 换模型报向量维度错误:原索引与新模型不兼容,恢复原配置或建新库重传,改维度数字没用
官方文档还提示可以搭配网页搜索能力互补:知识库存自维护的资料,网页搜索补实时信息。